검색 누락, 사이트가 아니라 태그 한 줄이 원인일 때
글을 꾸준히 올리는데 구글에서 사이트 이름을 쳐도 안 나오면 답답하죠. 웹 사이트 검색 누락 복구 방법을 찾다 보면 원인이 콘텐츠가 아니라 noindex 태그 실수일 때가 있어요. 테스트 단계에서 넣어 둔 태그 한 줄이 배포 뒤에도 남아 있으면, 구글은 그 페이지를 검색 결과에 넣지 말라는 지시로 읽거든요.
📌 핵심 요약
noindex를 지우고, robots.txt가 그 페이지를 막고 있지 않아야 복구가 시작돼요.
구글이 페이지를 다시 크롤링할 수 있어야 태그가 사라진 것도 알아챕니다. 고친 뒤에는 서치 콘솔 URL 검사로 지금 상태를 다시 봐야 해요.
📑 목차
noindex와 robots.txt 차단, 검색 누락에서 어떻게 다른가요
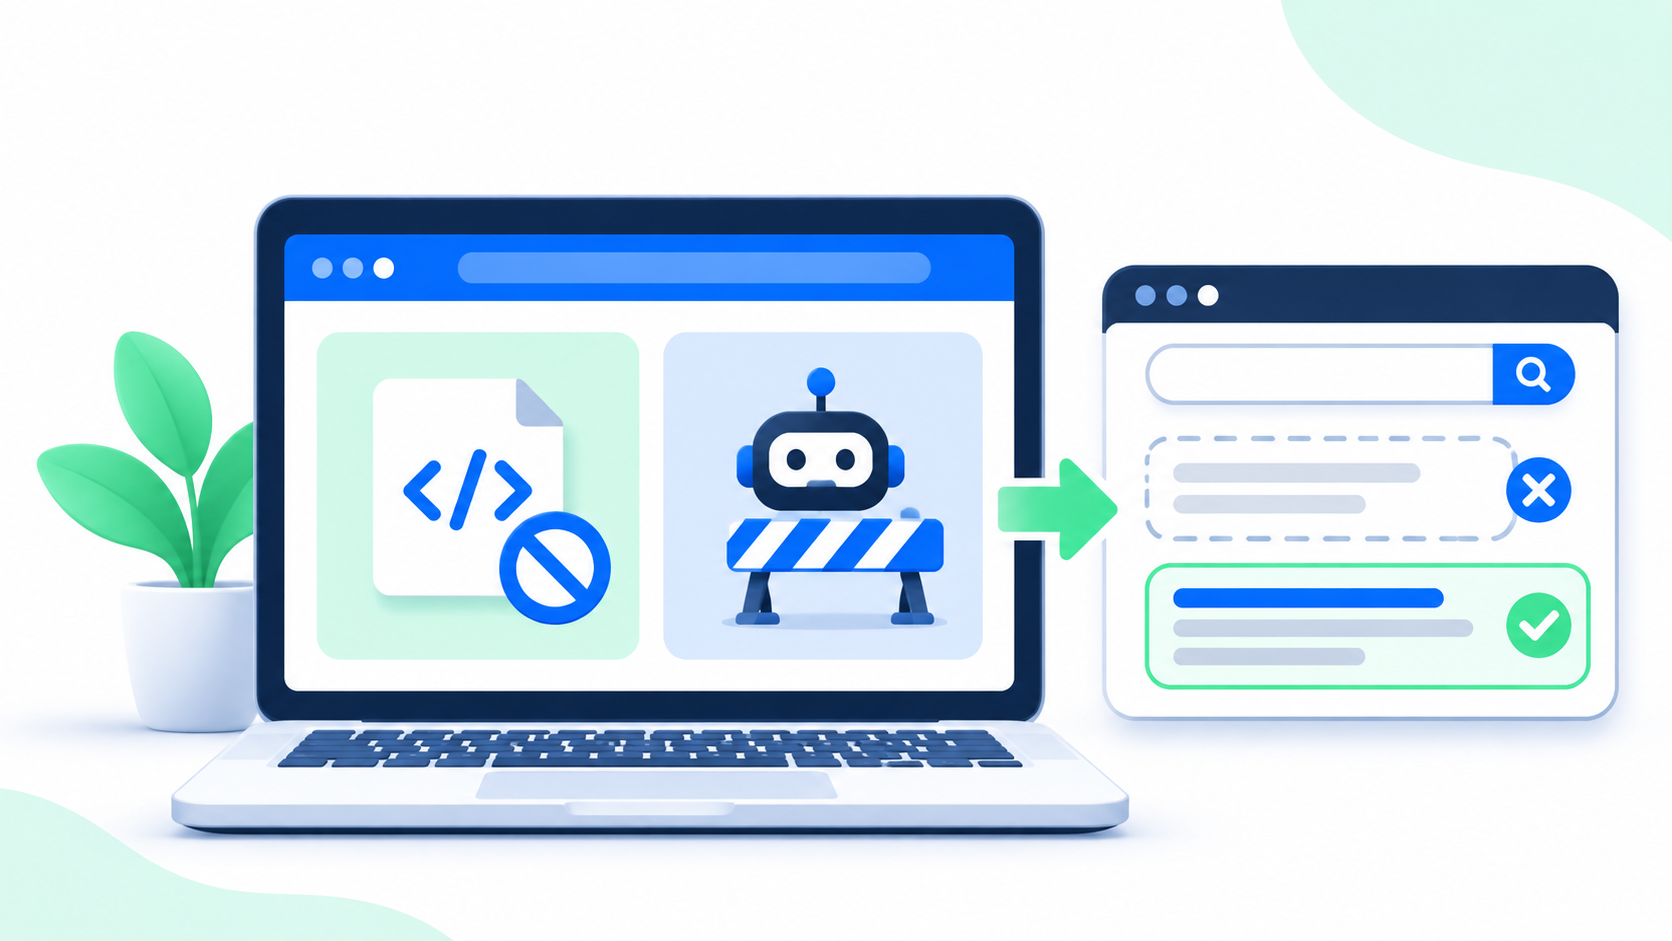
둘은 반대 방향으로 움직여요. robots.txt는 구글이 페이지에 들어오지 못하게 하고, noindex는 구글이 들어와서 읽은 뒤에야 효력이 생기죠. 이 차이를 모르면 고친다고 한 조치가 오히려 복구를 늦춥니다.
noindex 태그 실수 1: 개발용 설정을 남긴 채 배포
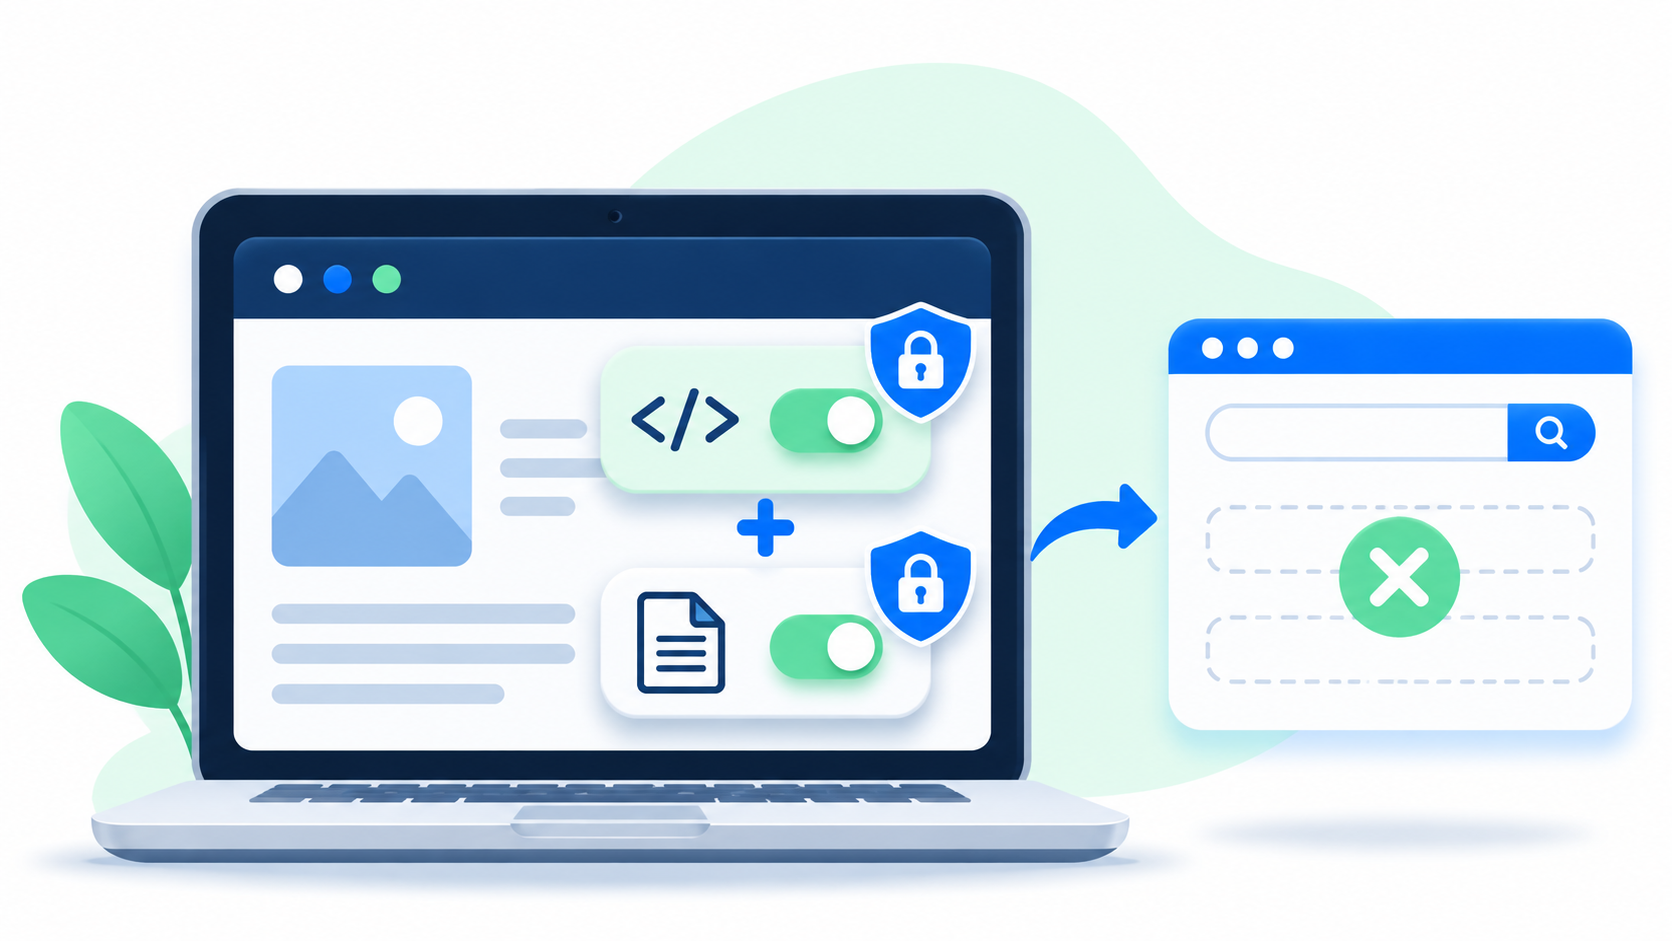
가장 자주 보이는 경우는 테스트 서버에서 쓰던 설정이 운영 사이트로 그대로 넘어오는 거예요. 워드프레스라면 설정 > 읽기 메뉴의 검색엔진 노출 옵션이 체크된 채 남아 있을 수 있고, 다른 빌더도 검색엔진 숨김 스위치를 따로 둡니다. 직접 보는 방법은 어렵지 않아요. 브라우저에서 페이지 소스 보기를 열고 robots를 검색해 <meta name='robots' content='noindex'> 같은 줄이 있는지 찾으면 됩니다.
소스에 없는데도 제외된다면 서버가 X-Robots-Tag 헤더로 보내고 있을 수 있어요. 이때는 개발자 도구 네트워크 탭에서 응답 헤더까지 열어 봐야 합니다. noindex 말고 다른 원인까지 넓게 짚고 싶다면 이 주제를 처음부터 정리한 글(우리 블로그의 누락 실수 자가 진단 글)을 함께 보세요.
실수 2: noindex 페이지를 robots.txt로 한 번 더 막기
누락된 페이지를 정리하겠다며 robots.txt에 Disallow 줄을 추가하는 경우가 있어요. 그런데 구글 검색 센터 문서는 noindex가 효과를 내려면 robots.txt가 그 페이지를 막지 않아야 한다고 설명합니다. 막혀 있으면 구글이 페이지를 다시 읽지 못하니, 나중에 noindex를 지워도 그 변화를 알아채지 못하거든요. 결국 두 가지를 모두 걸어 두면 복구도, 숨기기도 제대로 안 되는 상태가 됩니다.
⚠️ 주의사항
robots.txt로 막힌 주소도 다른 사이트의 링크를 타고 설명 없이 검색 결과에 나올 수 있어요. 숨기는 것이 목적이라면 robots.txt가 아니라 noindex를 써야 하고, 살리는 것이 목적이라면 둘 다 풀어야 합니다.
noindex 지운 뒤 서치 콘솔에서 복구 진행 보는 순서
실제 URL 테스트 돌리기
URL 검사 도구에 주소를 넣고 실제 URL 테스트를 누르세요. 처음 뜨는 결과는 구글이 예전에 저장한 상태라서 고친 내용이 반영되지 않았을 수 있어요.
robots.txt에서 해당 경로 풀기
그 경로를 막는 Disallow 줄을 지운 다음, 테스트 결과에 크롤링 허용이 나오는지 봅니다. 여기서 막히면 3단계로 가도 소용이 없어요.
색인 생성 요청은 한 번만
두 테스트를 통과하면 색인 생성 요청을 누르세요. 요청이 곧바로 색인을 보장하지는 않으니, 같은 주소를 반복해서 누르기보다 시간을 두고 다시 검사하는 편이 낫습니다.
noindex 태그 실수가 다시 생기지 않게 막는 설정
한 번 고쳤어도 테마를 바꾸거나 SEO 플러그인을 업데이트하면 같은 일이 다시 생길 수 있어요. 그래서 배포할 때마다 아래 항목을 짧게 훑는 습관이 복구보다 훨씬 덜 번거롭습니다.
📋 체크리스트
☑ 테스트 서버는 noindex 대신 비밀번호로 잠그기
☑ 사이트맵에 noindex 페이지 넣지 않기
☑ 플러그인 업데이트 뒤 검색 노출 옵션 다시 보기
비밀번호 방식을 권하는 이유는 단순해요. 설정 파일이 운영 서버로 복사되더라도 noindex 태그가 따라오지 않으니까요.
오늘 바로 해볼 한 가지
지금 서치 콘솔을 열고 페이지 색인 생성 보고서에서 'noindex' 태그에 의해 제외됨 항목을 눌러 보세요. 목록에 숨기려던 적 없는 글이 있다면, 그중 주소 하나를 골라 위의 세 단계를 그대로 따라가면 됩니다. 반대로 목록이 비어 있다면 원인은 noindex가 아니라는 뜻이죠.
✅ 이렇게 하면 됩니다
주소 하나로 먼저 끝까지 해 보고, 그 페이지가 다시 색인되는 걸 본 다음에 나머지 주소로 넓히세요. 한꺼번에 고치면 어떤 조치가 효과를 냈는지 알 수 없거든요.
자주 묻는 질문
Q. noindex를 지웠는데 왜 아직 검색에 안 나오나요?
Q. 페이지 소스에 noindex가 없는데도 제외로 나와요
Q. 검색에서 숨기려면 robots.txt와 noindex 중 무엇을 써야 하나요?
Q. 색인 생성 요청을 여러 번 누르면 더 빨라지나요?
참고자료
- Google 검색 센터 - noindex로 검색 색인 생성 차단 — noindex 메타 태그와 X-Robots-Tag 헤더 사용법, robots.txt와 함께 쓰면 안 되는 이유를 설명하는 구글 공식 문서
- Google 검색 센터 - robots.txt 소개 — robots.txt가 하는 일과 한계, 차단된 주소가 검색 결과에 남을 수 있는 경우를 다룬 공식 문서
- Search Console 고객센터 - URL 검사 도구 — 실제 URL 테스트와 색인 생성 요청 기능 사용법을 안내하는 공식 도움말